Ihr Sprachmodell kann Texte formulieren, Informationen zusammenfassen und Fragen beantworten. Die internen Abläufe Ihres Unternehmens kennt es jedoch nicht. Handbücher, Richtlinien, Verträge oder Supportfälle sind in einem öffentlichen Modell normalerweise nicht enthalten. Retrieval-Augmented Generation (RAG) schließt diese Lücke.
Das Verfahren verbindet ein Sprachmodell mit einer eigenen Wissensbasis, ohne es bei jeder Änderung neu zu trainieren. Dabei entsteht eine Verarbeitungskette, die weit über den KI-Server hinausgeht.
Was genau RAG macht
Bei RAG sucht das System zuerst nach Informationen, die zur gestellten Frage passen. Die gefundenen Textstellen werden gemeinsam mit der Frage an das Sprachmodell übergeben. Erst daraus formuliert das Modell seine Antwort. Ein interner Assistent kann beispielsweise technische Dokumentationen, Prozessbeschreibungen oder Produktinformationen durchsuchen. Fragt jemand nach einem bestimmten Ablauf, erhält das Sprachmodell die passenden Auszüge aus den freigegebenen Unterlagen. Das Modell lernt diese Inhalte dabei nicht dauerhaft. Es erhält sie im Moment der Anfrage als zusätzlichen Kontext. Einfach erklärt, handelt es sich bei RAG funktional um ein erweitertes System-Prompting. Nur vielfach komplexer.
Vom Dokument zur Wissensbasis
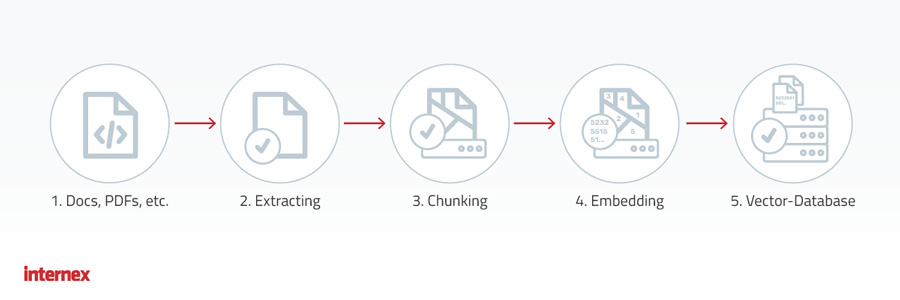
Bevor die KI Unternehmenswissen nutzen kann, müssen Quelldokumente aufbereitet werden. Dieser Vorgang wird häufig als Ingestion bezeichnet und erfolgt in fünf Schritten:
1. Datenquellen festlegen
Als Quellen kommen Dateiablagen, Wikis, Datenbanken, Ticketsysteme oder PDF-Dateien infrage. Dort liegen häufig freigegebene, vertrauliche und veraltete Inhalte nebeneinander. Vor dem Import muss daher klar sein, welche Daten verwendet werden dürfen und wer darauf zugreifen kann und darf.
2. Inhalte extrahieren
Das System liest die Texte aus den Dateien aus. Gescannte Dokumente benötigen eine Texterkennung. Bei Tabellen, Bildern und komplexen PDFs darf die Struktur nicht verloren gehen. Andernfalls arbeitet die KI mit unvollständigen oder falsch zugeordneten Informationen.
3. Texte aufteilen
Im nächsten Schritt werden die Inhalte in kleinere Abschnitte zerlegt, sogenannte Chunks. Ein vollständiges Handbuch ist für eine Anfrage meist zu umfangreich. Zu kleine Abschnitte verlieren dagegen ihren Zusammenhang. Die passende Größe hängt vom Dokument und Anwendungsfall ab. Metadaten wie Quelle, Erstellungsdatum oder Zugriffsgruppe helfen Suchergebnisse einzugrenzen und Berechtigungen durchzusetzen.
4. Embeddings erstellen
Ein Embedding-Modell wandelt jeden Textabschnitt in eine Zahlenfolge um. Dieser Vektor bildet die inhaltliche Bedeutung mathematisch ab. Dadurch kann das System beispielsweise erkennen, dass eine Frage zur „Wiederherstellung von Daten“ zu einem Dokument über „Backup und Restore“ passt, obwohl andere Begriffe verwendet werden.
5. Vektoren speichern
Embeddings, Textabschnitte und Metadaten landen schlussendlich in einer Vektor-Datenbank. Sie bildet die durchsuchbare Wissensbasis und kann weiterhin vertrauliche oder personenbezogene Informationen enthalten. Eine Zahlenfolge macht den ursprünglichen Inhalt nicht automatisch anonym.
Was bei einer Anfrage passiert
Auch die Frage wird in ein Embedding umgewandelt. Die Vektor-Datenbank sucht anschließend nach passenden Abschnitten. Häufig wird diese semantische Suche mit Stichwortsuche und einer zusätzlichen Bewertung kombiniert.
Die besten Ergebnisse werden in den Prompt eingebaut. Dieser enthält typischerweise:
- Regeln für das Verhalten des Systems
- Die Frage und relevante Teile des Gesprächs
- Gefundenen Textabschnitte
- Vorgaben für Aufbau und Form der Antwort
Das Sprachmodell formuliert daraus die Antwort. RAG reduziert dabei frei erfundene Aussagen, verhindert sie aber nicht. Das Modell kann Quellen falsch interpretieren oder widersprüchliche Inhalte vermischen. Kritische Antworten müssen überprüfbar bleiben.
RAG ist kein Fine-Tuning
RAG und Fine-Tuning erfüllen zwei unterschiedliche Aufgaben. Bei RAG bleiben Unternehmensinformationen außerhalb des Sprachmodells. Dokumente lassen sich aktualisieren, sperren oder aus dem Suchindex entfernen. Das eignet sich für Wissen, welches sich regelmäßig ändert. Beim Fine-Tuning wird ein Modell mit zusätzlichen Beispielen weiter trainiert. Dadurch lassen sich Tonalität, Ausgabeformat oder die Bearbeitung bestimmter Aufgaben beeinflussen. Als Wissensdatenbank ist Fine-Tuning weniger geeignet: Einzelne Inhalte sind schwerer zu aktualisieren und kaum gezielt aus den Modellgewichten zu entfernen. Weiters liegt Fine-Tuning in der Regel nicht in der Hand einzelner Unternehmen.
Der Chat ist nur ein Teil der Datenverarbeitung
Ein RAG-System verarbeitet mehr als die sichtbare Frage und Antwort. Abhängig von der Architektur entstehen oder durchlaufen folgende Daten mehrere Komponenten:
- Originaldateien und extrahierte Texte
- Chunks, Metadaten und Embeddings
- Fragen und Gesprächsverläufe
- abgerufene Dokumentpassagen
- generierte Antworten
- Nutzungs-, Fehler- und Sicherheitsprotokolle
- Zwischenspeicher und Backups
Für die Bewertung zählen daher auch Dokumentenaufbereitung, Embedding-Modell, Vektor-Datenbank, Protokollierung und Datensicherung.
Lokal gespeichert heißt nicht lokal verarbeitet
Eine Architektur speichert Dokumente und Vektoren im eigenen Netzwerk, nutzt für die Antwort aber ein externes Sprachmodell. In diesem Fall verlassen zumindest die Frage und die abgerufenen Textpassagen die lokale Umgebung. Werden Embeddings über eine externe Schnittstelle erstellt, fließen Unternehmensinhalte bereits während der Indexierung an einen Drittanbieter. Weitere Verbindungen können durch Telemetrie, Fehlerberichte oder Monitoring entstehen. Ein belastbarer lokaler Betrieb muss den gesamten Datenfluss abdecken. Die Frage für Unternehmen lautet daher: Wo läuft jede Komponente und welche ausgehenden Verbindungen bestehen?
Berechtigungen schützen vor Datenlecks
Die Suche darf nur Inhalte liefern, auf die eine Person auch in der ursprünglichen Quelle zugreifen könnte. Werden Rechte nicht übernommen oder laufend synchronisiert, kann die KI vertrauliche Informationen aus anderen Abteilungen oder Kundenbereichen ausgeben. Veraltete Dokumente führen zu veralteten Antworten. Manipulierte Inhalte können zudem versuchen Systemanweisungen zu überschreiben. Bei einer solchen indirekten Prompt Injection wird das Dokument selbst zum Angriffspunkt. Quellen müssen kontrolliert, Versionen gepflegt und die Rechte der KI begrenzt werden. Protokolle verdienen ebenfalls Aufmerksamkeit. Vollständige Prompts und Antworten erleichtern die Fehlersuche, schaffen jedoch auch eine zusätzliche Sammlung sensibler Informationen.
Diese Fragen sollten Unternehmen klären
Vor der Umsetzung eines RAG-Systems sollten zumindest folgende Punkte beantwortet sein:
- Welche Quellen und Daten sind tatsächlich notwendig?
- Wie werden vorhandene Zugriffsrechte übernommen?
- Wo laufen Aufbereitung, Embedding, Suche und Sprachmodell?
- Welche Informationen verlassen die vereinbarte Infrastruktur?
- Werden Eingaben für Training oder Produktverbesserung verwendet?
- Wie lassen sich Dokumente, Embeddings, Chats und Backups löschen?
- Welche Protokolle entstehen und wer darf sie einsehen?
- Wie werden Aktualität, Quellen und Antwortqualität geprüft?
Fazit: Kontrolle braucht den gesamten Datenfluss
RAG macht internes Wissen für Sprachmodelle nutzbar, ohne das Modell bei jeder Änderung neu zu trainieren. Das Verfahren ist flexibel, erweitert aber den Datenfluss um mehrere Komponenten. Bei der Frage nach dem Standort und Ort der Datenverarbeitung ist stets das Sprachmodell und alle involvierten Komponenten genau zu prüfen. Nur so kann sichergestellt werden, dass lokales Unternehmenswissen auch lokal bleibt.
Kontrolle entsteht erst, wenn der Weg vom Originaldokument über Embeddings und Vektor-Datenbank bis zum Prompt, zur Antwort und zu den Protokollen nachvollziehbar bleibt.
Sie möchten Unternehmenswissen mit einer eigenen KI nutzbar machen? Wir unterstützen bei der Planung und beim kontrollierten Betrieb einer DSGVO-konformen RAG- und KI-Infrastruktur in Österreich.